 邹文安
景杰编者按:在蛋白质组学研究中,研究人员通常用合成的肽段来对质谱检测的数据进行验证,但是之前合成的肽段数量不多,没能覆盖整个蛋白质组。日前,德国慕尼黑工业大学Bernhard Kuster团队成立了名为ProteomeTools的项目,合成并且采用液相色谱串联质谱分析了超过330,000条人工合成的肽段信息,基本上覆盖了典型的人类基因产物。相关成果发表在著名学术期刊Nature Methods上。相关数据分享在http://www.proteometools.org及ProteomicsDB或ProteomeXchange上,研究人员计划将整个数据库扩展至100万条肽段以上,以实现对人类蛋白质组的深度覆盖。景杰生物作为全球蛋白质与修饰领域的领跑者,可以为您提供完善的蛋白组学解决方案,从高灵敏度的修饰类抗体到高通量修饰组学,为您的研究助一臂之力。
蛋白组学的研究极大程度上依赖于质谱技术的发展及生物信息学分析,以推断复杂样品中蛋白质的成分与定量信息。尽管蛋白组学功能非常强大,但是仍然有很多工艺上以及概念上的局限性使得检测全蛋白组面临极大的挑战。这些局限部分源自于蛋白质分子组成的复杂性,譬如基因表达、mRNA的可变剪切、蛋白质的翻译后修饰等等因素,从本质上讲,我们不太可能实现对全蛋白组精确组成的完全剖析。除此之外,一成不变的统计方法也不利于复杂样本中蛋白质的鉴定。在分析化学中,合成的内标经常被用来确证某物质是否存在。然而,在蛋白组学的检测体系中,此类标准品的合成及应用才刚刚起步。为促进这种方法的快速发展,研究人员成立了名为“Proteome Tool”的项目,旨在合成约140万条特异性的肽段,覆盖人类所有的蛋白,形成庞大的肽段数据库。截止文章发表为限,研究人员已经合成并用LC-MS/MS检测了大于330,000条合成肽段,基本上覆盖了Swissprot数据库中注释的典型人类蛋白。除此之外,研究人员计划合成200,000条肽段用于检测蛋白变体,例如蛋白质的同分异构体、重要的天然或病理变体等。另外合成350,000条肽段包含各种翻译后修饰信息,例如磷酸化、乙酰化、甲基化、泛素化和单糖基化。尽管这部分肽段较难合成,但是研究人员认为它们的意义也许更大,因为修饰往往影响蛋白的酶活性从而调节蛋白的功能。未来,这些肽段可以提供精准的保留时间、碎裂模式等内容,为蛋白组学鉴定或靶向蛋白组提供优质的谱图信息(图1)。
(Figure 1 Overview of the ProteomeTools project)
ProteomeTools一个重要的目的在于生成质谱的参考标准用于人类肽段或蛋白的鉴定以及定量。研究人员总共获得1,131万张匹配谱图(PSM,Andromeda score cutoff > 100),匹配211,895条肽段,每个基因的覆盖度在9条肽段(中位数),为98.5%的人类蛋白质提供了高质量参照谱图。有趣的是,由于人和小鼠的序列同源性较高,这个肽段库也包含了60,961条鼠源肽段,覆盖了77%(12,599条)小鼠unique基因,也意味着这些肽段的利用范围可能不仅仅局限于人类。
(Figure 2 Data analysis and application)
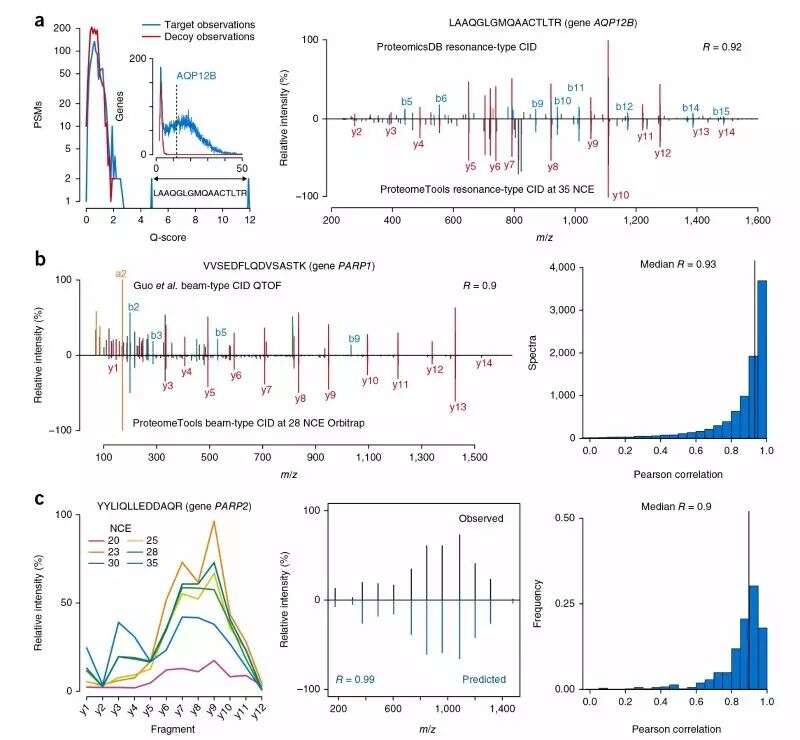
合成肽段的参考标准谱其中一个显著用途是可以用来确证罕见或新型蛋白。研究人员记录了6种不同NCE模式下的HCD谱,可以实现例如SRM、PRM、SWATH等靶向蛋白组的鉴定。此外,研究人员正在检测带化学标记如TMT或二甲基标记后肽段的谱图,以在稳定同位素标记的定量方法中得到更广泛的应用。
(Figure3 Peptide identification across different acquisition methods)
截止目前为止该项目所有的数据均公布在ProteomeXchange和ProteomicsDB上,并且以后也会将有价值的资源继续共享到公共数据库。同时,研究人员计划在未来两年内建立一系列针对重要功能蛋白的靶向分析,包括磷酸激酶、与信号传导相关的磷酸化肽段等等。我们相信,ProteomeTools项目对于整个蛋白质组学的发展将会是非常有价值的资源。
参考文献:
Zolg D P, Wilhelm M, Schnatbaum K, et al. Building ProteomeTools based on a complete synthetic human proteome. Nature Methods, 2017.